
目录大纲
配置美洽智能客服机器人的自动回复知识库,核心在于通过“梳理标准问答、批量导入数据、拓展意图与相似问、设置未匹配兜底以及打通平滑转人工链路”五大环节,构建结构化的人机协同服务体系。通过科学配置知识库,企业可有效拦截80%以上的日常高频咨询,显著缩短客户等待时间并降低人工坐席负荷。
为什么企业必须系统化搭建客服知识库?
根据维基百科(Wikipedia)对“知识库系统”的定义,知识库是用于优化信息收集、组织与检索的集中式数据库。在客户服务实践中,许多企业初期仅把机器人当作简单的“关键词自动回复器”,导致客户遇到稍微口语化的表述便出现“答非所问”的情况。
在知名职业社交平台 LinkedIn 的客户体验(CX)专栏中,众多行业专家指出:高效的智能客服不仅依赖自然语言处理(NLP)算法,更依赖底层知识库的颗粒度与逻辑流转。借助美洽客服机器人平台,企业可以将零散的业务制度、产品手册转化为多维度的标准QA,让算法能够精准识别访客意图,达成“秒级精准回复”。
第一步:基础问答库搭建与常见问题批量导入
搭建知识库的第一步是整理核心问答对(Question & Answer)。如果企业已有沉淀的客服记录或FAQ文档,可以通过模板进行批量录入,避免人工逐条添加的低效。
1. 搭建科学的知识分类树
在进入后台配置前,建议按照业务模块建立不超过3级的树状分类目录。例如:
- 售前咨询:产品规格、版本对比、价格方案、试用申请;
- 售后支持:发票开具、账号密码找回、功能故障排查;
- 物流与交付:发货周期、快递查询、退换货政策。
2. Excel 批量导入方法与规范
美洽提供了标准的导入模板,批量导入时应遵循以下关键规范:
- 下载官方标准模板:进入美洽机器人后台的“知识库管理”,点击“导入”,下载系统提供的标准 Excel/CSV 模版。
- 规范字段格式:标准问题(主问)尽量简明扼要,避免修饰词;答案内容支持纯文本、富文本链接及图片占位符;所属分类必须与系统中已建的分类层级名称保持完全一致。
- 预检特殊符号与重名:检查单元格内是否含有异常换行符、不可见字符,并确保主问题不与库内现有标准问重复,随后上传文件并执行系统校验。
第二步:意图识别关联与相似问拓展策略
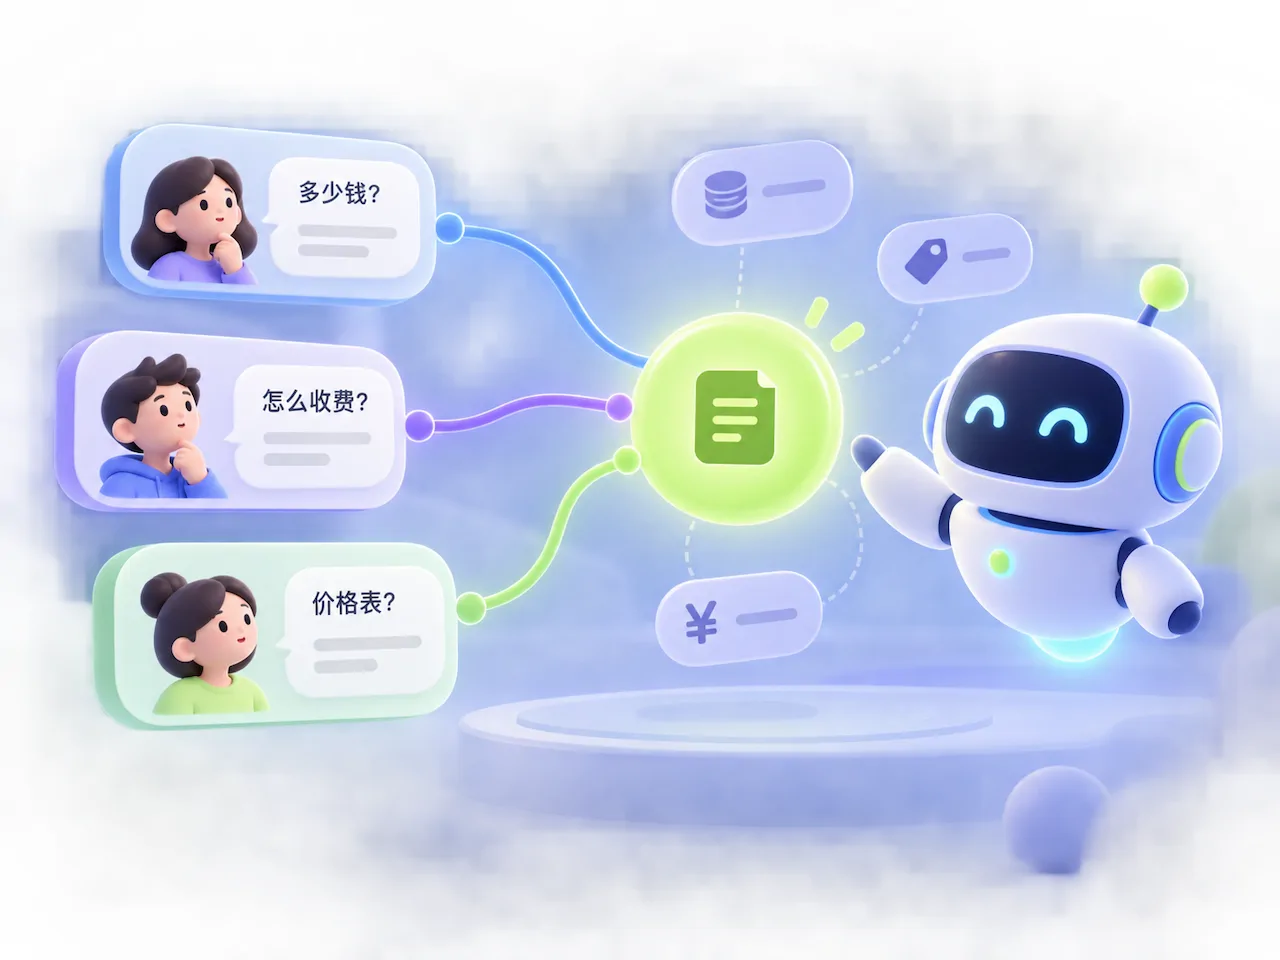
用户在提问时表达方式千差万别,例如“多少钱”、“怎么收费”、“价格表有吗”本质上都是同一个诉求。如果只配置标准问,机器人命中率将大打折扣。
1. 意图聚类与相似问扩充
在美洽后台编辑单条知识点时,重点是添加相似问法(Similar Questions)。系统借助语义理解模型,会将相似问作为训练语料,自动关联访客的同义表达。
- 口语化转换:添加缩写、口语化简称(如将“如何开具增值税专用发票”扩展为“专票怎么开”)。
- 情境提问:结合场景设想提问(如“付款失败了”、“钱扣了没到账”)。
- 避免语义交叉:不要将含义相差甚远的两个意图绑在同一个标准问下,否则会导致意图识别混淆。
2. 匹配模式选择对比
| 配置维度 | 精准关键词匹配 | 意图语义匹配(推荐) |
|---|---|---|
| 识别原理 | 文本完全包含指定关键词 | 基于语义向量计算相似度 |
| 维护成本 | 高,需要不断穷举各种词组组合 | 低,输入3-5个典型相似问即可自适应 |
| 容错能力 | 极低,错字或语序变化易失效 | 较强,能理解倒装句、同义词与口语表达 |
| 适用场景 | 特定指令(如输入“1”获取活动) | 常规业务咨询、产品使用与售后答疑 |
第三步:未匹配话术引导与一键转人工逻辑闭环
即便知识库再完善,依然存在长尾问题或超出机器人能力范围的复杂诉求。此时,“兜底回复”与“转人工机制”是防止用户流失的关键安全网。
1. 未匹配(兜底)话术设计
当访客输入的信息无法匹配到任何意图时,切忌直接显示冷冰冰的“系统错误”。在 Reddit 的 r/CustomerService 社区中,多次调研显示,生硬的死循环回复是造成客户反感的主要诱因。优质的兜底话术应包含以下要素:
- 礼貌告知局限:“抱歉,我还在学习中,未能完全理解您的问题。”
- 智能推荐热门问题:调用知识库中访问量最高的前 3-5 个高频问题供访客点击。
- 提供备选操作路径:直接给出“转接人工客服”或“提交工单留言”的快捷入口。
2. 一键转人工的触发逻辑
在美洽管理后台中,转人工策略可以设置为平滑过渡的混合模式:
- 关键词主动触发:当访客输入“人工”、“投诉”、“经理”等预设敏感词时,直接触发坐席路由。
- 连续未命中被动触发:设定阈值(如连续2次匹配失败),系统自动弹出转人工卡片或直接分配坐席。
- 常驻辅助按钮:在聊天窗口底部常驻“转人工”快捷按钮,把对话控制权完全交给访客,避免客户产生被机器人拦截的受挫感。
常见问题 (FAQ)
Q1: 批量导入知识库时提示格式错误或导入失败,通常是什么原因?
最常见的原因包括:直接修改了模板表头的字段名称、所属分类层级在系统中未提前创建、单条答案包含不受支持的宏代码,或单次导入数据量超出了单批次限制。建议每次导入控制在 500-1000 条以内,并严格使用纯文本编辑器检查是否有异常格式。
Q2: 机器人答非所问时,应该如何定位并调整?
可在美洽后台的“对话记录”或“未解决问答分析”中找到该对话,查看系统当时的意图命中置信度得分。如果命中错误知识点,需检查该知识点下是否存在语义模糊的相似问;如果是未能识别,直接在该条用户原话右侧点击“关联已有知识点”将其添加为相似问,完成模型微调。
Q3: 企业刚上线美洽机器人,没有现成的问答库怎么办?
建议采取“冷启动三步法”:首先,调取过去1-3个月的人工客服聊天记录,用词频工具筛选出排名前30的高频问题作为首期QA;其次,开启机器人的“辅助人工模式”,由坐席在日常接待中一键将优质回复沉淀至库中;运行两周后,再根据报表中的未命中统计进行第二轮补充。
Q4: 机器人能实现针对不同渠道(如官网、微信、APP)展示不同知识库吗?
可以。在美洽系统中,企业可以通过配置多应用或差异化接待分组,将特定的知识库分类或机器人形象绑定至指定渠道,实现“售前渠道侧重产品营销问答、售后渠道侧重技术指导”的精细化分流运营。
